発走前のデータで、同じことができるのか
前回は、予測結果を複勝の払戻と結びつけ、
ROIなどの収益性を比較する評価条件を検証したところまでを書きました。
過去データでは一定の傾向が見える条件があり、
次は未来のレースで確かめようという段階へ進みました。
ただ、過去の検証では、レースが終わったあとの情報を使っています。
当日の出馬表には、まだ着順もタイムもありません。
オッズも変わりますし、必要な情報がいつ揃うかも考えなければなりません。
学習済みモデルのファイルがあっても、
それだけでは発走前のレースを予測できませんでした。
モデルへ渡す材料を、その時点で入手できる情報から作る処理が必要です。
まずは、発走前に一度取る
2026年4月に考えた最初の運用は、比較的単純なものでした。
発走前の一定のタイミングで出馬表HTMLを取り、
当日専用のパーサーでCSVへ変換し、過去履歴と合わせて推論する。
条件に合う予測結果があれば、最後は人間が確認する想定でした。
この時点では、単勝オッズをプログラムから取得するところまではできていませんでした。
取れない項目は手動で補い、まず当日運用へ持っていく方針でした。
すべてを自動化してから使い始めるのではなく、
今のモデルを動かせる入力を用意することを優先しました。
ただ、モデルへ渡すのは対象レースだけでは足りませんでした。
既存の推論処理は、過去の成績や出走間隔など、
履歴から作る特徴量も内部で計算していました。
当日1レース分しか入力しなければ、過去の出走情報がありません。
そのため、過去履歴を残したうえで当日分を加える必要がありました。
当日のレース一覧を、時間割として使う
1レースずつページを開いて保存していては、
運用のたびに人間が張り付くことになります。
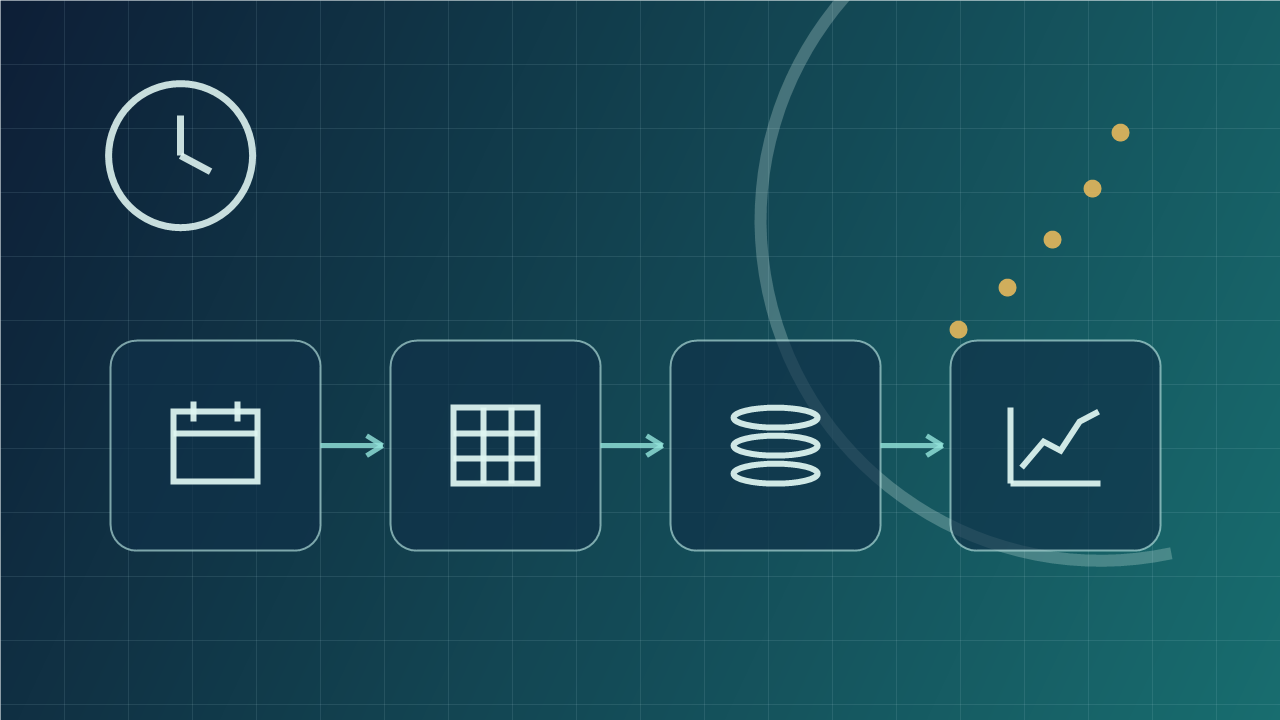
5月に入り、最初に自動化したのは当日のレース一覧でした。
日付を指定して一覧ページを取得し、HTMLを日付付きで保存します。
そこからレースIDや発走時刻などを取り出して、
当日のスケジュールCSVを作りました。
対象日を使った確認では、レース一覧を解析し、
出力されたCSVの内容も確認できました。
レースIDは個別ページへ進むために使い、
発走時刻はいつ取得するかを決めるために使います。
元のHTMLも保存しているので、
CSVの内容に疑問があれば、解析前のページへ戻って確認できます。
取得と解析を分ける形は、過去データを集めた時と同じです。
過去の結果ページと、当日の出馬表は別でした
次に、スケジュールCSVにあるレースIDを使って、
各レースの出馬表HTMLを取得する処理を作りました。
この時も対象レース分の取得を確認できましたが、
保存したHTMLの日本語が文字化けする問題が出ました。
ファイルはUTF-8で保存しているのに、
HTML内に書かれた文字コード指定が一致していなかったためです。
保存方法とHTML側の指定を合わせることで、文字化けは解消しました。
また、過去の学習用HTMLと当日の出馬表では、ページの構造も役割も違います。
同じようなファイル名にすると、後からどちらなのか分かりにくくなります。
そこで、当日用には today_race_ という名前を付け、
パーサーも専用に作ることにしました。
過去用のコードをそのまま使い回すのではなく、
当日HTMLから必要な情報を取ったあとで、既存CSVの列構造へ合わせます。
空欄にも、理由がある
当日パーサーでは、まず1レース分の抽出に成功しました。
レースIDが正しく入り、馬名や騎手名にも文字化けがないことを確認しています。
当日の出馬表が、ようやくモデルへ渡せそうな表になりました。
しかし、CSVには空欄も残りました。
着順やタイムが空なのは、まだレースが終わっていないためです。
これは取得漏れではなく、発走前のデータとしては当然の空欄でした。
odds_win(単勝オッズ)の空欄は、別の問題でした。
既存の推論処理では、当日のオッズ情報も入力の一部として必要でした。
画面には表示されるのに、保存した出馬表HTMLだけでは値を取り出せませんでした。
結果がまだないために空なのか、
必要な情報を取得できていないために空なのか。
同じ空欄でも、当日運用での意味は違います。
この段階では出馬表の基本情報を先に通し、オッズの取得は次の作業にしました。
現在時刻から、次の対象レースだけを取る
一覧と個別HTMLを取得できたので、
次はスケジュールにある全レースを毎回取るのではなく、
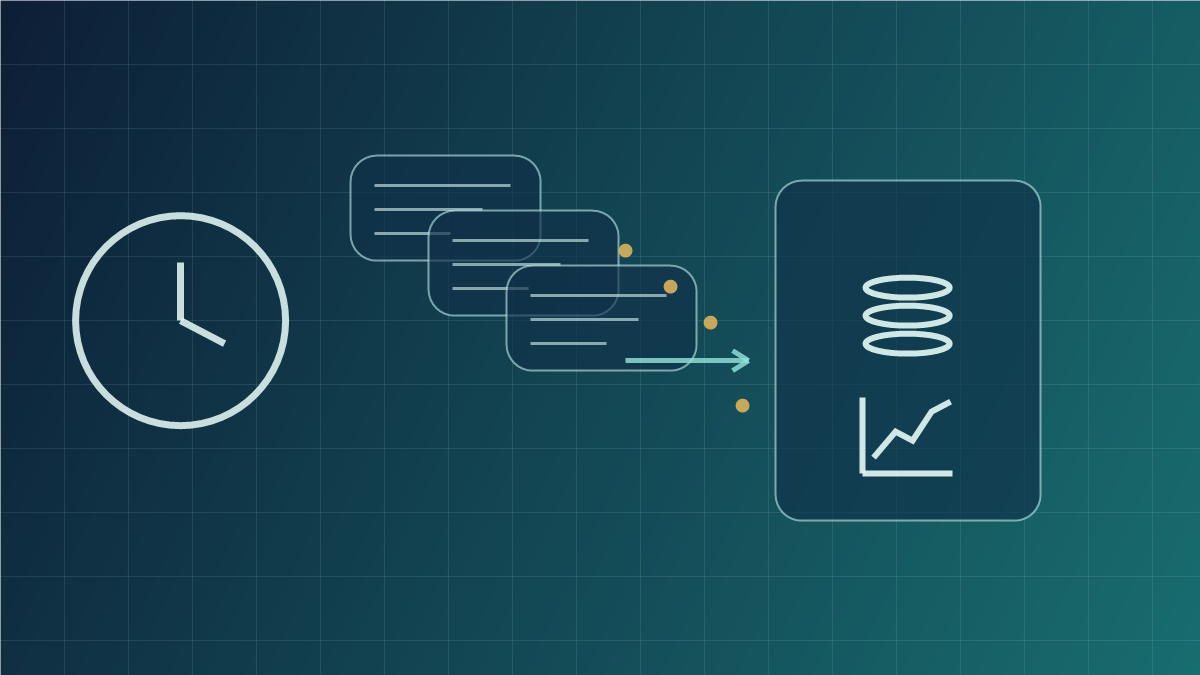
現在時刻から一定時間内に始まるレースを選ぶ処理を作りました。
テストでは日付と現在時刻を指定し、
その時点で発走が近い複数のレースが対象になることを確認しました。
最初の実行でHTMLを取得し、同じ条件でもう一度動かすと、
保存済みのレースはスキップされました。
これで、時間が進むたびに新しく対象へ入ったレースを取り、
すでに保存したものは使い続ける形が見えてきました。
当初の「発走前に取得する」という運用案を、
スケジュールと現在時刻で判断できる処理にしました。
ただし、この時点では人間が時刻を指定して実行しています。
定期的な自動実行ができたのは、もう少し後です。
まずは時刻を渡した時に、正しい対象を選び、
同じレースを重ねて取らないことを確かめました。
作り直すCSVと、残しておくスナップショット
複数レースのHTMLを扱うようになると、
1レースごとの出力を当日1日分のCSVへまとめる処理も必要になりました。
レースIDと馬IDで重複を整理し、
レース情報と出走馬情報をそれぞれ作るようにしました。
HTMLから作り直せる中間CSVとは別に、
運用用のスナップショットを残しました。
スナップショットには、その時点の当日データを保存します。
当時の運用案では、取れないオッズを手入力で補う可能性がありました。
その値を、HTMLを再解析するたびに消してしまっては困ります。
まずは、解析結果を更新しつつ、補ったオッズを保持できる形を作り、
実際に再実行して値が残ることを確認しました。
また、当日の未確定データを、
確定済みの履歴へそのまま混ぜ続ける方針も見直しました。
履歴は結果が確定したデータとして持ち、
当日スナップショットは予測時点を再現するために別に残す。
推論する時に両者を一時的に組み合わせる方向へ整理していきました。
最初は既存CSVへ当日分を追記する案でしたが、
取得や再実行を繰り返すうちに、保存するデータの役割も整理されていきました。
当日運用の入口が、一つの処理になりました
5月16日には、対象レースの取得から、
当日entries、当日races、スナップショット更新までを、
一つのコマンドで実行できるようになりました。
モデルそのものは変えていませんが、
まだ結果のないレースのデータを、
これまでの仕組みへ渡す準備が進みました。
残っていた大きな穴は、オッズです。
当日予測に必要な情報を、当日のデータへどう組み込むか。
次回は、この問題に取り組み、当日のスナップショットから予測までをつないでいった過程を書きます。