CSVの次に、何をすればよいのか
前回の記事では、競馬サイトから保存したHTMLを解析し、
レース情報と出走馬情報を二つのCSVへ整理したところまでを書きました。
レースごとに一つの情報は races_parsed.csv、
出走馬ごとに異なる情報は entries_parsed.csv へ保存し、
両方を race_id で関連づける形です。
ようやく、機械学習モデルが学習するための材料が見える形になりました。
しかし、CSVができたからといって、
次に何をすれば予測モデルになるのかを理解できていたわけではありません。
何を正解として学習させるのか。
どの項目を予測の材料にするのか。
文字列や欠損した値をどう扱うのか。
作ったモデルが良いか悪いかを、どう確かめるのか。
考えることはいくつもありましたが、
当時の私には、どれが正しい選択なのか分かりませんでした。
そこで、最初から正解を決めようとするのではなく、
まず機械学習を一度最後まで動かしてみることにしました。
この時、先に大量のデータを集めるのではなく、
すでにある1週分のサンプルを使って、
取得、整形、学習、評価までの流れを完成させる方針を選んでいました。
データ件数を増やしても、扱う項目そのものが増えるわけではありません。
それなら、まず小さなデータで全体を一度通し、
必要になったところで大量取得へ進む方がよいと考えました。
DBまで一度通し、次に学習へ進みました
この頃には、Docker上のPostgreSQLに、races、horses、race_entries を用意し、
CSVからデータを投入する処理まで実装していました。
race_id の対応や重複の問題を修正し、
CSV側の36レースとDB側の36レースが、
1対1で対応する状態まで確認しています。
そのうえで、次は機械学習まで含めた流れを一度通すことにしました。
最初に作った学習コードは、二つのCSVを直接読み込む構造でした。
実際に使ってみると、それで特に困りませんでした。
むしろ、まだ仕様が固まっていない時期には、
CSVの方が試行錯誤しやすい場面も多くありました。
そのため、その後の学習開発でもCSVの利用が続きました。
CSVは、試しながら変えるのに都合がよかった
スクレイピングで保存したHTMLを前処理して作ったCSVを、
そのまま機械学習の入力として使えました。
取得する日付や対象を増やしてHTMLを集め、前処理を実行すれば、
学習に使えるデータも増やせます。
機械学習のコードは、そのCSVをそのまま読み込みます。
別の期間や条件で作ったデータを試したければ、
読み込むCSVを差し替えることもできます。
列を追加したり、値を確認したり、
途中のデータを目で追ったりすることも難しくありません。
DBを使うなら、データを投入する処理だけでなく、
重複や更新、削除、スキーマの変更なども考える必要があります。
もちろん、DBにはDBの利点があります。
しかし、どのデータが必要かも、どんな形にするかも変わり続ける段階では、
先に構造を固めることが試行錯誤の負担になる場合があります。
この段階でCSVを使い続けることは、
試行錯誤を速く回すための選択でした。
当時の私に必要だったのは、保存方法を完成させることより、
何を変えると結果がどう変わるのかを早く確かめることでした。
変更しやすく、差し替えやすく、
それまでに作ったスクレイピング処理も、そのまま活かせる。
仕様が固まっていなかったからこそ、
CSVの単純さは、この探索段階に合っていました。
正解と材料を、ひとまず仮決めしました
最初のコードでは、races_parsed.csv と entries_parsed.csv を読み込み、race_id を使ってレース情報と出走馬情報を結合しています。
予測する対象は、以前に決めていた通り、
その馬が3着以内に入るかどうかです。
着順が3着以内なら 1、それ以外なら 0 として、
機械学習にとっての正解を作りました。
最初の特徴量には、斤量や年齢、枠番、馬番、距離などの数値情報に加え、
性別、馬場状態、天候、競馬場などのカテゴリ情報も使いました。
文字で表されたカテゴリは、One-Hot Encodingによって、
モデルが扱える形へ変換しています。
前処理も、まずは単純な方法にしました。
必要な数値が欠けている行は学習対象から外し、
カテゴリ値の欠損は「不明」として扱います。
単勝オッズはCSVにありましたが、欠損が多いことを想定し、
最初の特徴量からは外しました。
これらが最善だったから選んだわけではありません。
目的変数も、特徴量も、欠損値の扱いも、
まず一回動かすための仮決めでした。
正しい設計が分かってから実行するのではなく、
実行できるところまで決めて、結果を見にいく。
この時点では、その順番で進むことにしました。
とにかく一度、最後まで動かしました
学習に使うレースと、結果を確かめるためのレースも分けました。
同じレースの馬が両方へ混ざらないよう、race_id 単位で分けています。
そして、最初のモデルとしてXGBoostを使いました。
ここで重要だったのは、XGBoostの仕組みを詳しく理解することよりも、
CSVの読み込みから結合、前処理、学習、評価までを、
一つの流れとして最後まで通すことでした。
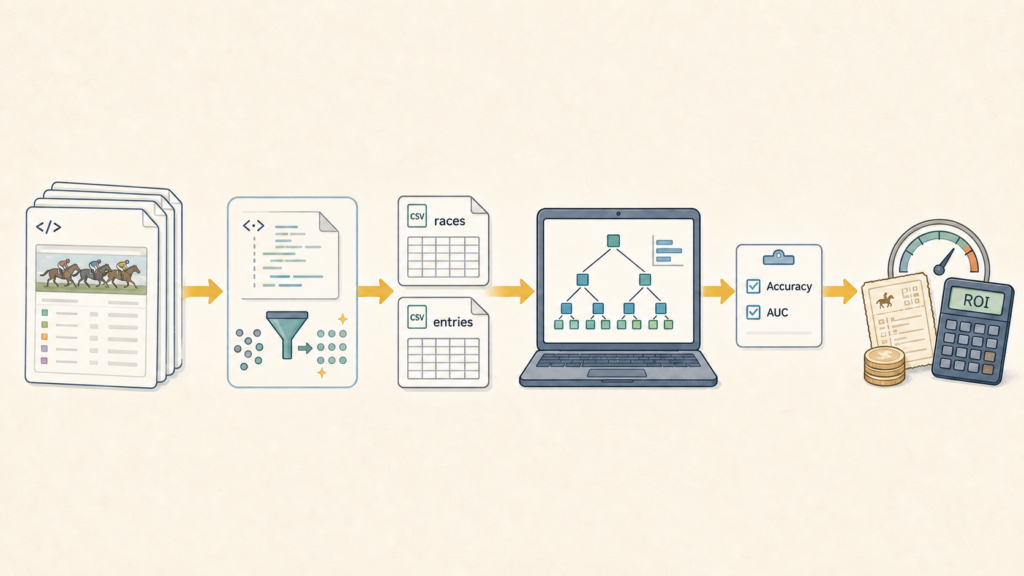
コードを実行すると、CSVの読み込みから学習、評価まで処理が進み、
AUCやAccuracyといった評価値が表示されました。
Accuracy約73%を、どう見ればよいのか分かりませんでした
初回の実行結果では、Accuracyは約73%でした。
ただ、当時の私には、約73%という数字が良い結果なのか、
悪い結果なのかを判断できませんでした。
Accuracyという数字を、何と比べ、
どう受け取ればよいのかも分かっていませんでした。
一方、AUCは約0.497でした。
当時の私はAUCについてもよく分かっていなかったため、
ChatGPTに、AUCなどモデル評価の読み方を相談しました。
そこで、AUCが0.5前後では、3着以内に入る馬を
うまく見分けられているとは言いにくいという説明を受けました。
評価用データにあった3着以内の馬は24件。
そのうち、正しく3着以内と判定できたのは3件だけでした。
残りの21件は見逃しています。
3着以内ではない馬の方が多いため、
そちらを多く当てればAccuracyは高く見えます。
こうした説明と実際の判定件数を合わせて見ることで、
Accuracyだけを見ても、競馬AIとして使えるのかは判断できないことが分かってきました。
動かしたから、次に考えることが見えてきました
競馬AIで目指していたのは、
高精度な分類器を作ること自体ではありません。
最終的には、予測が収益につながるかまで確かめたいと考えていました。
この段階で行っていたのは、
過去データ上でモデルの予測と払戻を結びつけ、
収益性まで評価できる仕組みを作ることでした。
最初のベースラインモデルを動かしたあと、
的中率やROI(回収率)、最大ドローダウンなど、
分類評価とは別の指標でも結果を見たいと考えるようになりました。
予測確率とオッズから期待値を考えることも含め、
モデルの分類性能と収益性を分けて検証できるようにしたいと考えていました。
今振り返ると、これは途中の一部分を先に最適化するより、
まず最終評価まで届く流れを作ろうとしていたのだと思います。
収益性を評価できない状態で特徴量やモデルを調整しても、
途中の評価値が変わっただけでは、
本当に目的へ近づいたのか判断できません。
何が正解か分からないから、まず最後まで動かす。
小さなデータで学習と評価まで通したことで、
次に必要な評価の形が見えてきました。
機械学習モデルの評価値が返るところまでは到達しました。
次は、その予測を過去の払戻と結びつけ、
ROIなどの収益性をどう評価するのか。
開発は、その段階へ進もうとしていました。