前回のおさらい
前回の記事では、AIを学ぶための題材として、なぜ競馬AIを選んだのかについて書きました。
競馬にはデータがあります。
結果も明確です。
毎週のように新しいレースがあり、予測と結果を比較できます。
AIを使ってAIを学ぶための題材として、競馬はとても魅力的に見えました。
しかし、競馬AIを作ると決めても、すぐにコードを書き始めたわけではありません。
最初に必要だったのは、何を作るのかを決めることでした。
競馬AIと一言で言っても、その中身はさまざまです。
どの馬券を対象にするのか。
的中率を重視するのか、回収率を重視するのか。
どのレースを対象にするのか。
どのようなデータを集めるのか。
どの技術を使うのか。
考えるべきことは、想像以上にたくさんありました。
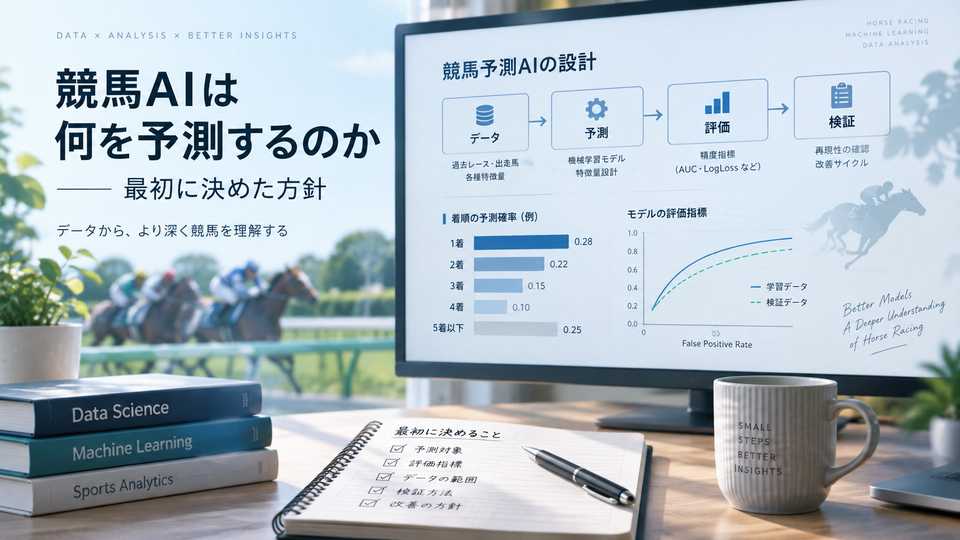
そこで私は、まず競馬AIの最初の方針を整理することにしました。
まず決めるべきは「何を予測するか」でした
競馬AIを作ると言っても、何を予測するかによって難易度も目的も変わります。
単勝を当てるのか。
複勝を当てるのか。
ワイドを狙うのか。
三連複や三連単のような高配当を狙うのか。
一発で大きく勝つことを目指すなら、高配当の馬券を狙う選択肢もあります。
しかし、私は最初から高リスクな方向には進みませんでした。
このプロジェクトの目的は、競馬で一攫千金を狙うことではありません。
AIを学び、Pythonを使い、データを扱い、将来的には副業にもつながる
可能性のある仕組みを作ることでした。
そのためには、最初から難易度の高い馬券に挑むよりも、
まずは継続的に検証しやすい対象を選ぶ方が良いと考えました。
そこで最初の予測対象として選んだのが、複勝でした。
正確には、馬が3着以内に入る確率を予測することです。
競馬AIの最初の目標は、「この馬が勝つかどうか」ではなく、
「この馬が複勝圏に入る可能性がどれくらいあるのか」を予測することになりました。
なぜ複勝から始めるのか
複勝を選んだ理由は、単に当たりやすそうだからではありません。
もちろん、単勝や三連単に比べれば、複勝は的中しやすい馬券です。
しかし、それ以上に、機械学習の題材として扱いやすいと感じました。
3着以内に入ったかどうか。
これは結果が明確です。
入ったなら1。
入らなかったなら0。
このように分類問題として扱いやすい形になります。
機械学習の最初の題材としても、結果を確認しやすい対象でした。
さらに、予測した複勝圏内確率を実際のオッズと照らし合わせれば、
モデルを的中率だけでなく、収益性の観点から評価することもできます。
私が作りたかったのは、なんとなく当たりそうな馬を選ぶ仕組みではありません。
データをもとに確率を出し、その結果を実際のレース結果やオッズと比較しながら、
予測の意味を検証できる仕組みでした。
その出発点として、複勝は扱いやすく見えました。
的中率と回収率、どちらを重視するのか
次に考えたのは、的中率と回収率のどちらを重視するのかという問題です。
競馬予想というと、どうしても的中率に目が行きます。
何回当たったのか。
どれだけ外さなかったのか。
これは分かりやすい指標です。
しかし、的中率が高ければ利益が出るとは限りません。
低いオッズの馬ばかりを買い続ければ、
たとえ多く当たっても、最終的にはマイナスになる可能性があります。
一方で、回収率を重視すれば、利益に直結しやすくなります。
ただし、回収率だけを追い求めると、的中率が下がり、外れが続くこともあります。
外れが続けば、どれだけ理屈では正しくても、精神的に続けるのが難しくなります。
ここは、私にとってかなり重要なポイントでした。
副業として続ける可能性を考えるなら、収益性も無視できません。
しかし、一時的に良い数字が出るだけでは、継続して評価できる仕組みにはなりません。
そこで、回収率を主要な評価指標の一つにしつつ、
的中率や結果の安定性も合わせて見ることにしました。
一つの数字だけで良し悪しを決めないことが、最初の方針になりました。
予測確率とオッズをどう評価するか
この段階で、競馬AIの最初の形が少し見えてきました。
複勝圏に入る確率を予測する。
その予測を、実際のオッズや結果と照らし合わせる。
そして、的中率だけでは見えない部分も含めて評価する。
これは、私の中ではかなり大きな違いでした。
人気馬を多く選べば、的中率は高く見えるかもしれません。
しかし、それだけでは予測が実用的なのか判断できません。
逆に、たまたま大きな払戻があれば、
少ない試行でも回収率だけは良く見えることがあります。
だからこそ、予測確率、的中率、オッズ、回収率を
一つずつ切り離さずに見る必要があると考えました。
この考え方は、予測モデルに任せる部分と、
人間が設計する部分の違いを考えるきっかけにもなりました。
予測モデルは確率を出す。
しかし、その数字をどの指標で評価するのか。
どのくらいの期間や件数で検証するのか。
そこは人間が設計する必要があります。
競馬AIは、モデルにすべてを任せるものではありません。
予測結果をどう検証し、次の改善につなげるかまで含めたプロジェクトでした。
対象レースも絞ることにしました
次に考えたのは、どのレースを対象にするかでした。
最初からすべてのレースを対象にすることも、できなくはありません。
しかし、競馬は条件によって性質が大きく変わります。
競馬場。
距離。
芝かダートか。
馬場状態。
クラス。
新馬戦なのか、未勝利戦なのか、条件戦なのか、重賞なのか。
これらをすべてまとめて扱うと、
データの傾向がばらけてしまう可能性があります。
そこで、最初は対象を絞る方針にしました。
中央競馬を対象にする。
初期は特定のコースや距離、条件に絞る。
精度が出しやすそうな領域から始める。
重賞や未勝利戦のように難しそうなものは、最初から無理に扱わない。
このような方針です。
これは、競馬AIに限らず、何かを作る時には大事な考え方だと思います。
最初から全部をやろうとすると、失敗した時に何が悪かったのか分かりにくくなります。
まずは狭く始める。
そこで検証する。
うまくいけば広げる。
うまくいかなければ見直す。
この段階で、競馬AIはかなりスモールスタートを意識したプロジェクトになっていました。
技術選定は、今できることだけで決めない
技術面でも、最初にある程度の方針を決めました。
基本はPythonとVS Codeです。
データ処理にはpandasやnumpy。
可視化にはmatplotlibなど。
機械学習にはscikit-learn、XGBoost、LightGBMなどを候補にしました。
ただし、この時点で細かく固定しすぎることはしませんでした。
大事なのは、目的に合わせて技術を選ぶことです。
今の自分が少しでも知っている技術だけを使えば、
最初の心理的なハードルは下がるかもしれません。
しかし、このプロジェクトには、
AI時代に向けて自分の技術の幅を広げる目的もありました。
だからこそ、今できることだけではなく、
これから必要になりそうな技術にも触れていきたいと考えていました。
Pythonもその一つです。
AIやデータ分析の世界でよく使われている技術を、
実際のプロジェクトの中で使ってみる。
それ自体が、この競馬AI開発の大きな目的でした。
データ取得はショートカットも許容する
競馬AIを作るには、当然データが必要です。
レース情報。
馬の情報。
騎手。
距離。
馬場。
過去成績。
結果。
オッズ。
集めるべきものはたくさんあります。
ただ、ここで最初からすべてを自作しようとすると、
おそらくそこで止まってしまいます。
このプロジェクトの目的は、
スクレイピング技術だけを極めることではありません。
競馬AIを作り、AIを学び、データを扱い、
改善できる仕組みを作ることです。
そのため、データ取得については、
既存の情報やコードを参考にしながら進める方針にしました。
もちろん、必要に応じて修正や拡張はしていきます。
しかし、最初からすべてを自分で作ることにはこだわりませんでした。
ここでも大事なのは、目的を見失わないことです。
学ぶために作る。
しかし、すべてをゼロから作る必要はありません。
使えるものは使う。
足りないところは直す。
その方が、プロジェクト全体を前に進めやすいと考えました。
改善サイクルまで考える
最初の方針決めでは、
モデルを一度作って終わりにするつもりはありませんでした。
競馬は毎週のように新しい結果が出ます。
傾向が変わることもあります。
使えるデータが増えることもあります。
だから、モデルも必要に応じて更新していく必要があります。
最初は手動で十分です。
データを追加する。
結果を確認する。
評価指標を見る。
必要であれば再学習する。
その程度から始めれば良いと考えていました。
ただし、将来的にはこの検証サイクル自体の自動化も視野に入れていました。
予測を出す。
結果を記録する。
評価する。
必要ならモデルを更新する。
そうした流れを継続できれば、
単発の実験ではなく、長く検証できる仕組みに近づいていきます。
この時点ではまだ遠い話でしたが、
最初から改善サイクルを意識していたことは、
その後の開発にもつながっていきました。
最初の方針を決めて見えたこと
こうして、競馬AIの最初の方針を整理していきました。
複勝圏に入る確率を予測する。
回収率を主要な評価指標の一つにする。
ただし、的中率や結果の安定性も合わせて見る。
予測確率とオッズ、実際の結果を使って検証する。
対象レースは最初から広げすぎない。
Pythonを中心に、AIやデータ分析で使われる技術に触れていく。
データ取得は必要に応じてショートカットも許容する。
改善サイクルや将来の自動化も視野に入れる。
こうして並べてみると、
競馬AIは単にモデルを作るだけの話ではありませんでした。
馬券種を選ぶ。
評価指標を決める。
対象レースを絞る。
データの集め方を考える。
技術スタックを選ぶ。
運用や改善まで考える。
かなり広いプロジェクトだったのです。
そして、その広さに気づけたこと自体が、
最初に方針を整理した大きな意味だったと思います。
いきなりモデルを作るのではなく、
何を予測し、何を評価し、どの範囲から始めるのかを先に決める。
この整理が、その後の開発の土台になりました。
次回へ
こうして、競馬AIの最初の方針が決まりました。
とはいえ、この段階ではまだ何も動いていません。
方針は決まりました。
しかし、実際に形にするには、Pythonの環境を整え、データを集め、処理を書き、モデルを作っていく必要があります。
ここからようやく、競馬AI開発は実作業に入っていきます。
次回は、ChatGPTを開発支援に使いながら競馬AIを作り始めた時のこと。
開発環境、そして実際にコードを動かし始めた時のことを振り返ってみたいと思います。